
От каталогов к кризису первых движков и прорыву PageRank
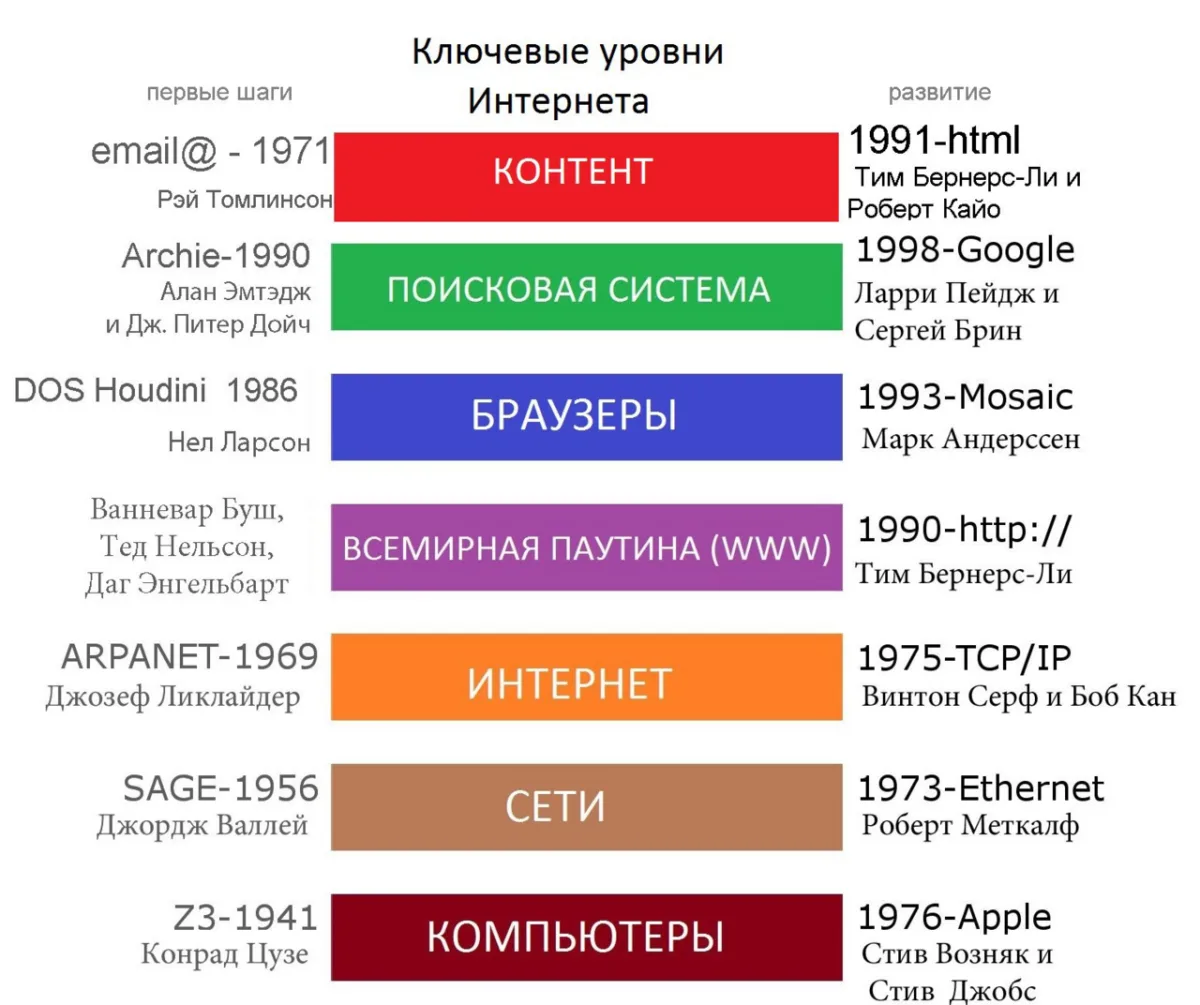
Задачу навигации в распределённых знаниях Ванневар Буш описал ещё в 1945 году в концепции Memex, но первые сетевые поисковики возникли с ростом файловых серверов. В сентябре 1990 года студент Университета Макгилла Алан Эмтэдж создал программу Archie для поиска по именам файлов в открытых FTP-архивах, а распространение Gopher породило утилиты Veronica и Jughead. В ранней Всемирной паутине список сайтов вручную вёл Тим Бернерс-Ли. В 1993 году появились первые веб-инструменты — робот World Wide Web Wanderer в MIT, W3Catalog, Aliweb и JumpStation, — а в 1994 году WebCrawler впервые ввёл полнотекстовую индексацию всех слов на странице. Вскоре рынок заполнили Lycos, мощный движок корпорации DEC AltaVista (1995), Excite, Infoseek и ручной каталог Yahoo! (1994).
К 1997 году первое поколение поисковиков зашло в тупик. Редакторы Yahoo! не успевали вручную проверять миллионы новых страниц, а частотно-текстовые движки вроде AltaVista легко обманывались скрытым наполнением ключевыми словами. Вдобавок гонка рекламных сделок (включая ротацию пяти поисковиков на стартовой странице Netscape за пять миллионов долларов в год) и спекулятивный пузырь доткомов превратили поисковые сайты в перегруженные баннерами и новостями порталы. Перелом совершили аспиранты Стэнфордского университета Ларри Пейдж и Сергей Брин, работавшие в рамках финансируемого Национальным научным фондом США (NSF) проекта цифровой библиотеки. В 1996 году они запустили экспериментальную систему BackRub, а в 1998 году описали в статье The Anatomy of a Large-Scale Hypertextual Web Search Engine алгоритм PageRank (упоминая и более ранний патент 1996 года на ссылочный метод RankDex Робина Ли). Спартанский интерфейс Google без лишнего мусора и модель продажи ключевых слов, заимствованная у GoTo.com в 1998 году, решили задачи релевантности и окупаемости. В России тем временем развивалась сильная лингвистическая школа: в 1996 году заработали Рамблер и Апорт, а 23 сентября 1997 года компания CompTek Аркадия Воложа и Ильи Сегаловича совместно с лабораторией ИППИ РАН академика Юрия Апресяна представила поисковик Яндекс (Yandex.ru), научившийся учитывать сложную морфологию русского языка.
Архитектура поисковой машины и математика PageRank
Классический веб-поисковик состоит из трёх модулей: робота-краулера, индексатора и системы выдачи. Робот непрерывно обходит сеть по гиперссылкам, считывая директивы файла robots.txt (где администраторы ограничивают индексацию разделов) и соблюдая политику обхода, чтобы не зациклиться в бесконечных скриптах. Индексатор очищает HTML-код, проводит лексический и морфологический разбор (приводя словоформы к словарным основам) и строит инвертированный индекс соответствия слов адресам страниц. Сохранение полных копий документов в кэше позволяет мгновенно выводить текстовые фрагменты запроса (сниппеты) и сохраняет доступ к информации при временной потере или изменении исходной страницы.
Алгоритм PageRank перенёс в интернет логику научного цитирования: гиперссылка с одного ресурса на другой трактуется как голос за его авторитетность, причём вес голоса пропорционален значимости самого ссылающегося сайта и распределяется между его исходящими ссылками. Благодаря итеративному пересчёту графа ссылок примитивная накрутка ключевых слов перестала гарантировать верхние строчки выдачи. Поддержание актуального индекса миллиардов страниц потребовало гигантской распределённой инфраструктуры дата-центров: уже к 2011–2012 годам серверный парк Google оценивался примерно в миллион машин при суммарной мощности около 220 мегаватт.
Экономика контекстной рекламы, монополии и «пузыри фильтров»
Разделение органического ранжирования и аукционных блоков контекстной рекламы с оплатой за клик сделало поисковые компании крупнейшими бенефициарами цифровой экономики, породило индустрию оптимизации сайтов (SEO) и ускорило развитие локальной торговли и науки. Вместе с тем доминирование одного игрока (к 2020-м годам глобальная доля Google составила около 89–92%) вызвало острые дискуссии о власти алгоритмов.
Исследователи фиксируют структурный перекос выдачи в пользу коммерческих и англоязычных источников, манипуляции политических и коммерческих групп («поисковые бомбы»), а также зависимость от локальной цензуры и законодательства — от фильтрации запрещённого контента в Европе и конфессиональных порталов вроде Halalgoogling до ухода Google из Китая (где лидирует Baidu), устойчивых позиций Яндекса в России и признания монополизма Google судом США в 2024 году. В 2011 году Илай Паризер выдвинул гипотезу пузыря фильтров, согласно которой персонализация по истории кликов изолирует человека от иных мнений, хотя часть социологов оценивает этот эффект как ограниченный.
Консолидация, машинное обучение и генеративный ИИ
В 2000-х годах рынок прошёл жёсткую консолидацию: Yahoo! поглотила Inktomi (2002) и Overture с AltaVista (2003), но в 2009 году перешла на платформу Microsoft Bing. Попытка запуска государственного поисковика Спутник в России (2014–2017) без органической экосистемы оказалась неудачной, подтвердив важность качества алгоритмов.
Сама технология поиска ушла далеко за пределы статического PageRank: ранжирование сегодня управляется нейросетями, поведенческими сигналами и графами знаний. С 2024 года начался новый этап — интеграция генеративных языковых моделей непосредственно в выдачу (ответы Google ИИ и Яндекс Нейро на базе YandexGPT), объединяющих факты из множества сайтов в связный ответ. Этот сдвиг делает поиск разговорным, но ставит перед обществом новые вопросы об авторских правах, трафике СМИ и проверке машинных фактов.