
Криптоанализ Холодной войны и Джорджтаунский прорыв 1954 года
Предпосылки машинного перевода восходят к частотному анализу арабского криптографа IX века Аль-Кинди и проектам универсального языка Рене Декарта (1629), а в 1930-х годах французский инженер Жорж Артцруни и советский учёный Пётр Смирнов-Троянский независимо запатентовали механические «переводные машины» (причём проект Троянского включал кодирование грамматических ролей на основе эсперанто, но оставался забытым до 1950-х).
Электронную эпоху открыла Вторая мировая война. В 1947 году Эндрю Бут в Англии и математик Фонда Рокфеллера Уоррен Уивер (в переписке с Норбертом Винером) предложили использовать ЭВМ для перевода, а в меморандуме 1949 года Уивер сформулировал идею рассматривать иностранный текст как шифр, применив военный криптоанализ и теорию информации Клода Шеннона. В 1951 году исследования запустили Иехошуа Бар-Хиллел в MIT и группа Джорджтаунского университета (Дэвид Хейс в RAND возглавлял компьютерную лингвистику с 1955 г.), а в 1954 году в Лондоне машина APEXC выполнила ранний перевод с английского на французский.
Резонансным стартом отрасли стал Джорджтаунский эксперимент 7 января 1954 года в нью-йоркской штаб-квартире IBM. Группа Леона Достерта и Михаила Заречняка совместно с инженерами IBM (Катберт Херд, Питер Шеридан) загрузила в ламповую ЭВМ IBM 701 словарь из 250 слов и 6 грамматических правил и публично перевела свыше 60 отобранных русских предложений из органической химии и политики. Репортажи на первых полосах The New York Times открыли поток щедрых ассигнований от Пентагона, ЦРУ, ВВС США (система Mark II для чтения советских журналов), Комиссии по атомной энергии и Европейского сообщества по атомной энергии; в 1955 году собственные проекты стартовали в СССР (школы О. С. Кулагиной и Р. Г. Пиотровского) и Японии.
От хрупких грамматик правил к статистическим корпусам и вниманию
Первое поколение строилось на правилах (RBMT): от пословной подстановки до трансферных и интерлингвальных систем с языком-посредником (коммерчески закрепилась лишь система KANT для нормированного технического языка Caterpillar в 1992 г.). Однако за пределами жёстких шаблонов правила рассыпались из-за многозначности: как доказал Бар-Хиллел ещё в 1950-х, без «универсальной энциклопедии» здравого смысла ЭВМ не способна выбрать верный смысл (пример переводчика ООН Клода Пирона — неоднозначная фраза «Japanese prisoners of war camp»).
На рубеже 1980–1990-х годов группа IBM создала систему Candide, доказавшую мощь статистического машинного перевода (SMT). Вместо ручного составления тысяч правил алгоритм извлекал вероятностные соответствия из миллионных параллельных корпусов (протоколы парламента Канады Hansard, Европарламента EUROPARL и ООН — к 2005 г. Google обучался примерно на 200 млрд слов ООН). Тем не менее SMT дробил предложения на короткие фразы и путался в согласовании падежей и морфологически богатых языках.
Революцию совершил нейронный машинный перевод (NMT). Ранние сети «кодировщик–декодировщик» теряли детали длинных фраз в едином сжатом векторе, пока Дмитрий Богданов (Bahdanau), Кёнхён Чо и Йошуа Бенжио (2014) не ввели механизм внимания (attention), позволивший декодеру динамически сопоставлять нужные фрагменты оригинала. В 2016 году Google запустил рекуррентную систему GNMT, а в 2017 году команда Google Brain (Ашиш Васвани и др.) предложила архитектуру Transformer, заменившую медленную последовательность самовниманием на GPU и обеспечившую скачок качества.
Кризис ALPAC (1966) и превращение в инфраструктуру глобализации
Сверхоптимизм 1954 года («полный перевод за 3–5 лет») привёл к жёсткому кризису. В 1966 году созданная правительством и Академией наук США комиссия ALPAC заключила, что машинный перевод медленнее, хуже и вдвое дороже работы человека. Прекращение грантов в США вызвало первую «зиму ИИ». До наступления нейросетей отрасль спасли ведомства и корпорации с потоком однотипной документации, где скорость важнее стиля: с 1970 года ВВС США и с 1976 года Еврокомиссия эксплуатировали SYSTRAN, во Вьетнаме работала система Logos, в Канаде с 1976 года трудилась система прогнозов погоды Météo, Xerox перешла на МП для инструкций (1978), а Европейские сообщества профинансировали крупный проект Eurotra.
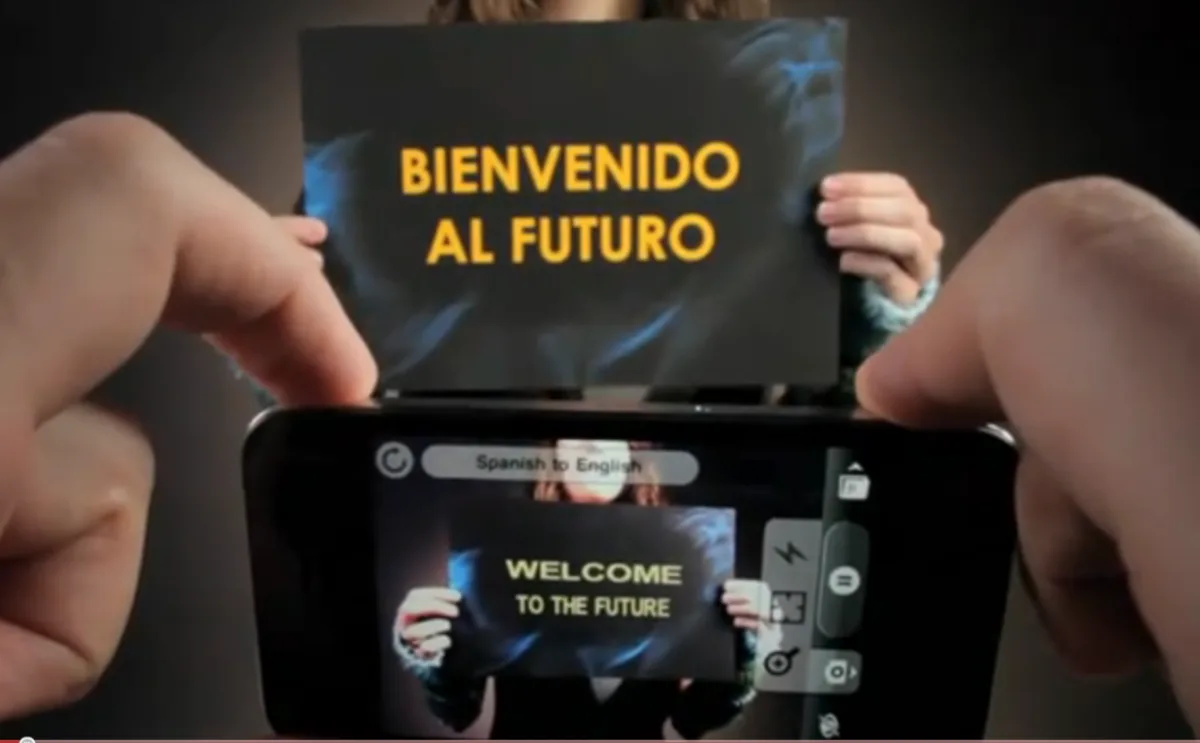
Массовые ПК и микрокомпьютеры 1980–1990-х годов (включая японские переносные модели Sharp, NEC, OKI и Sanyo) породили системы памяти переводов (Trados, 1989) и недорогие настольные переводчики (в России — ПРОМТ, чей неверный подбор словаря породил мемы вроде «Гуртовщиков мыши» для mouse driver). Выход в веб — от французского Minitel (1988) и бесплатного AltaVista Babelfish (1997, до 500 тыс. запросов в день) и Google Translate (миллион книг текста в день к 2012 г.) до DeepL и камерного перевода вывесок вроде Word Lens — разрушил языковые барьеры в туризме, науке, Википедии и торговле.
Большие языковые модели и границы «человеческого паритета»
В 2020-х годах специализированные NMT-системы дополнились генеративными большими языковыми моделями (LLM) на архитектуре трансформера. Они лучше учитывают широкий контекст документа и позволяют переводить малоресурсные и даже древние языки вроде аккадского, а также устную речь и язык жестов (прототипы вроде TEAM для ASL).
При этом исторический урок ALPAC сохраняет силу: громкие заявления о «человеческом паритете» работают лишь на узких бенчмарках вроде метрики BLEU. В медицине (риск ошибочных назначений), юриспруденции (утечка тайн в публичные облака и точность дефиниций) и художественной литературе машинный перевод остаётся лишь мощным черновиком, требующим обязательного контроля и постредактирования человеком.