
Перцептрон, «зимы ИИ» и возвращение коннекционизма (1958–2012)
История нейросетей развивалась в конкуренции с символьным искусственным интеллектом, опиравшимся на жёсткие логические правила. Отталкиваясь от модели формального нейрона Уоррена Мак-Каллока и Уолтера Питтса (1943), психолог Корнеллской авиационной лаборатории Фрэнк Розенблатт при финансировании Управления военно-морских исследований США (ONR) в 1957–1958 годах создал теорию перцептрона, а в 1960 году построил машину Mark I Perceptron для распознавания образов. Однако в 1969 году лидеры символьной школы из MIT Марвин Минский и Сеймур Пейперт в книге «Perceptrons» строго доказали неспособность однослойного перцептрона решать линейно неразделимые задачи вроде функции исключающего «ИЛИ» (XOR). После этого агентства вроде DARPA сократили гранты на нейросети в пользу экспертных систем, спровоцировав первую «зиму ИИ» 1970-х годов.
Возрождение началось в 1986 году, когда Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс популяризировали алгоритм обратного распространения ошибки (backpropagation) для обучения многослойных сетей. В 1990-е годы появились свёрточные сети Яна Лекуна (LeNet, применявшиеся для чтения почтовых индексов) и рекуррентные сети с долгой краткосрочной памятью (LSTM), предложенные Зеппом Хохрайтером и Юргеном Шмидхубером в 1997 году. Тем не менее из-за нехватки размеченных корпусов и слабых CPU в 1990–2000-х годах на практике доминировали статистические подходы — метод опорных векторов и сглаженные n-граммные модели языка (вроде статистических моделей выравнивания IBM и корпусов «веб как корпус»), которые к 2009 году превосходили символьные системы в обработке текста. Перелом обеспечила игровая индустрия: удешевление графических ускорителей (GPU) и платформа NVIDIA CUDA открыли эпоху массивно-параллельных вычислений. В 2012 году свёрточная сеть AlexNet (Алекс Крижевский, Илья Суцкевер, Джеффри Хинтон) с огромным отрывом выиграла конкурс ImageNet, а в 2014–2016 годах в обработке текста закрепились архитектуры seq2seq с механизмом внимания (Д. Бахданау и др., 2014; Google Neural Machine Translation, 2016).
Почему RNN уступили архитектуре Transformer
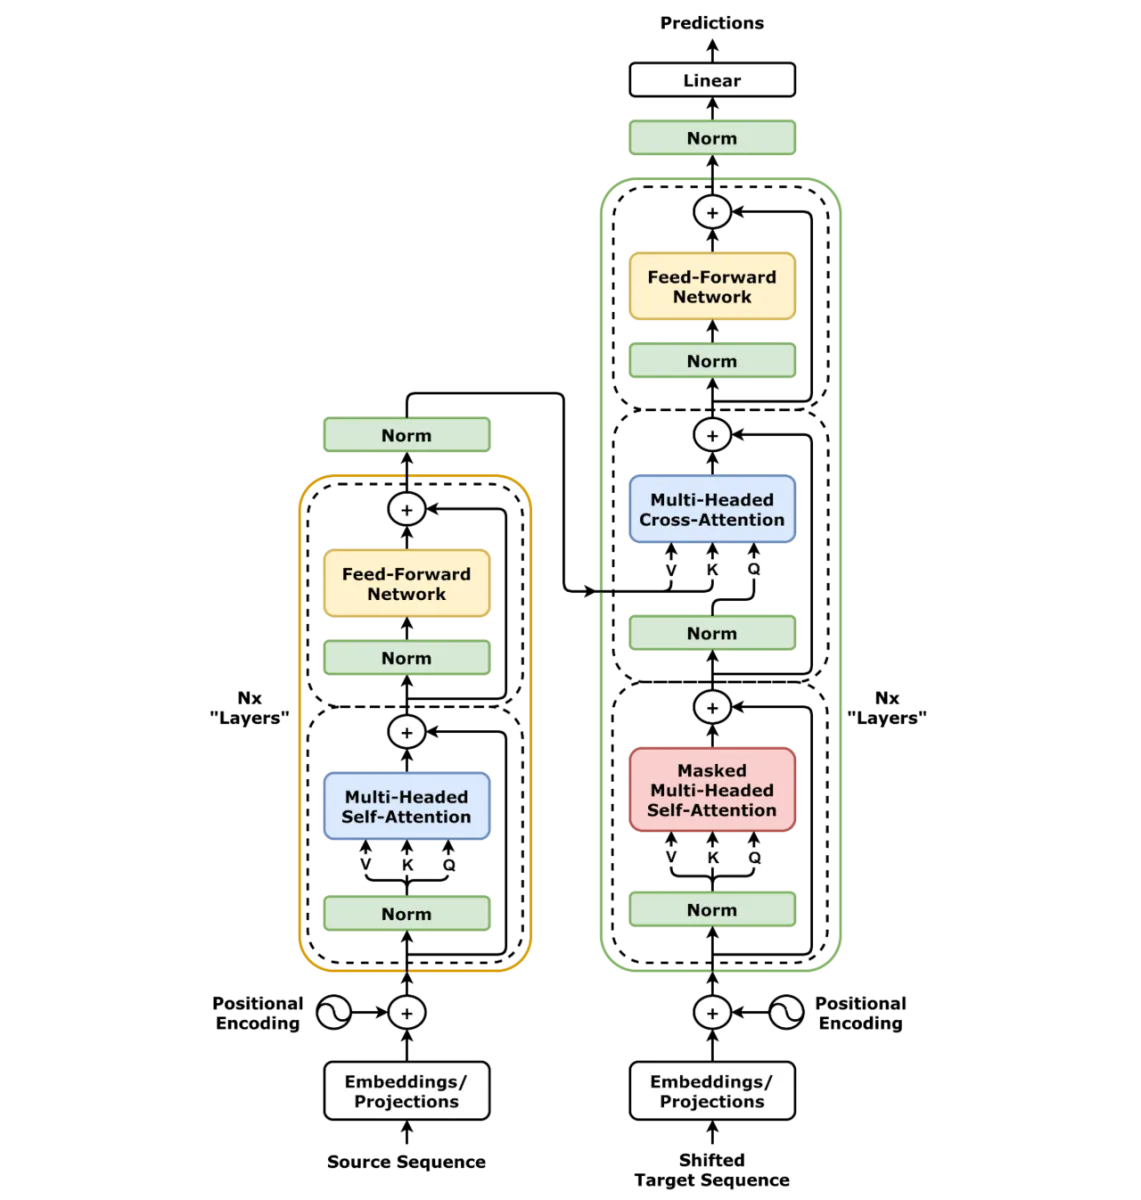
Даже улучшенные рекуррентные сети (RNN и LSTM) упирались в последовательную обработку текста — токен за токеном, что мешало параллельно загружать тысячи ядер GPU и ослабляло учёт дальних зависимостей в длинных предложениях. В июне 2017 года восемь исследователей Google Brain и Google Research (Ашиш Васуани и соавторы) опубликовали статью «Attention Is All You Need», представив архитектуру Transformer. Убрав рекуррентные циклы, авторы разбили входной текст на подслова-токены (алгоритмами вроде BPE или WordPiece) и соединили синусоидальное позиционное кодирование с механизмом многоголового самовнимания (Multi-Head Self-Attention) на основе матриц запросов, ключей и значений (Q, K, V).
Одновременная матричная обработка всего контекстного окна позволила эффективно распараллеливать обучение на кластерах GPU и TPU, запустив законы масштабирования: рост объёма неразмеченных текстов (до триллионов токенов) и числа параметров предсказуемо повышал качество моделей. Архитектура дала три направления больших языковых моделей (LLM): двунаправленные модели «только кодировщик» (BERT, 2018), обновившие интернет-поиск; полные системы «кодировщик–декодер» (T5) для перевода; и авторегрессивные генеративные модели «только декодер» с причинной маской внимания (линейка GPT от OpenAI), где самообучение предсказанию следующего токена сочеталось с тонкой настройкой на инструкциях и обучением с подкреплением на основе отзывов людей (RLHF).
Большие языковые модели и сдвиг в экономике, науке и политике
После закрытых экспериментов с GPT-2 (2019) и GPT-3 (2020, 175 млрд параметров) выпуск общедоступного чат-бота ChatGPT в ноябре 2022 года превратил LLM в массовый инструмент генерации текста, машинного перевода (включая сервисы Яндекса и Google) и программирования (GitHub Copilot). Крупнейшие корпорации развернули многомиллиардную гонку дата-центров, а передовые ускорители вычислений стали объектом стратегического экспортного контроля и технологического соперничества США и КНР.
Внедрение LLM обострило фундаментальные риски. Поскольку языковые модели вероятностно предсказывают токены, они подвержены «галлюцинациям» — уверенной генерации ложных фактов и несуществующих источников. Одновременно обучение на публичных корпусах веба и книг породило судебные иски об авторском праве, опасения по поводу трансформации рынка интеллектуального труда, автоматизации дезинформации и рисков кибербезопасности.
Открытые веса, оптимизация вычислений и «рассуждающие» модели
Высокая стоимость закрытых моделей вызвала контрволну систем с открытыми весами (LLaMA, Mistral) и инженерных прорывов экономии памяти: адаптации малого ранга LoRA и QLoRA (2023), 3–4-битного квантования (GPTQ, формат GGUF в библиотеке llama.cpp для локального запуска на обычных ПК), ускоренного внимания FlashAttention и GQA, а также разреженных сетей «смеси экспертов» (Sparse MoE — Mixtral 8x7B 2023 г., DeepSeek-V3 2024 г., активирующая лишь около 37 млрд параметров из 671 млрд на токен).
В 2023–2025 годах развитие сместилось к мультимодальности (обработка изображений, аудио и видео), «рассуждающим» моделям с явной генерацией цепочки мыслей перед ответом (OpenAI o1, открытая DeepSeek R1 января 2025 года) и автономным программным агентам, управляющим браузером и ОС. Вместе с тем ведущие учёные (Ян Лекун, Джуда Перл) подчёркивают, что вероятностное предсказание последовательностей ещё не означает подлинного понимания причинно-следственных законов физического мира.